Zpracování, synchronizace a řešení potíží
Rozsah zdroje určuje, co do kolekce vstoupí. Processing určuje, jak se obsah stane prohledávatelným. Retrieval určuje, které chunky dostane agent. Před vytvořením zdroje zkontrolujte profil zpracování a ověřte jej na reprezentativních souborech a otázkách. Nastavení zdroje, stavy aktualizací, odhady a chování při schválení popisuje Režim Discovery.
JSON Features a JSON Metadata Definitions
Když datový zdroj importuje JSON, tato dvě nastavení určují roli pojmenovaných polí:
| Nastavení | Praktická otázka | Doporučené použití | Typické klíče |
|---|---|---|---|
| JSON Features | Z jakého obsahu má AI čerpat? | Významový text, který má podporovat vyhledávání a odpovědi | title, description, summary, content, normalizovaný text komentářů |
| JSON Metadata Definitions | Podle čeho má systém dokument poznat, zařadit nebo případně filtrovat? | Stabilní identifikátory a řízené klasifikační hodnoty | id, category, author, language, createdAt, customerId |
Pole jsou dostupná v aktuálních formulářích pro vytvoření Manual Upload, Google Drive, OneDrive, SharePoint, Azure Storage Account a Azure File Share. Stejný klíč nevkládejte do obou seznamů bez konkrétního důvodu a retrieval testu.
Připravte JSON kontrakt
Před konfigurací kteréhokoli seznamu shromážděte:
- jeden až tři reprezentativní JSON objekty,
- příklady otázek, které budou uživatelé pokládat,
- klasifikace nebo filtry, které chtějí používat,
- příklady vnořených, volitelných nebo strukturálně nekonzistentních objektů.
Pro features upřednostněte stručný text s obchodním významem, pro metadata stabilní a normalizované skalární hodnoty. Vynechte binární obsah, přístupové tokeny nebo podepsané URL, interní hodnoty zpracování, duplicitní text a rozsáhlé objekty bez jasného přínosu pro retrieval.
Vnořené objekty, seznamy, chybějící hodnoty a klíč, který mezi záznamy mění datový typ, vyžadují stabilní upstream kontrakt. Vnořené hodnoty zploštěte do zdokumentovaných klíčů, normalizujte data a identifikátory a užitečné seznamy nebo komentáře v případě potřeby spojte do záměrného textového pole. Nepředpokládejte, že neotestovaná vnořená cesta bude interpretována požadovaným způsobem.
Příklad konfigurace
Uvažujte tento reprezentativní objekt:
{
  "id": "policy-1042",
  "title": "Password reset policy",
  "summary": "Rules for resetting an employee account password.",
  "content": "After a reset, the employee must create a new password and confirm multifactor authentication.",
  "category": "Identity",
  "author": "Security Operations",
  "language": "en",
  "createdAt": "2026-08-01T09:30:00Z",
  "_etag": "internal-revision-value"
}
Doporučené hodnoty:
JSON Features: title, summary, content
JSON Metadata Definitions: id, category, author, language, createdAt
| Klíč | Seznam | Důvod a očekávaný dopad |
|---|---|---|
title | Features | Přidá předmět a terminologii dokumentu do prohledávatelného obsahu. |
summary | Features | Poskytne stručný popis, který může zlepšit retrieval u obecných otázek. |
content | Features | Obsahuje fakta, ze kterých se mají vytvářet odpovědi. |
id | Metadata | Poskytne stabilní identifikátor logického záznamu. |
category | Metadata | Klasifikuje záznam pro kontrolu a zamýšlené filtrování podle kategorie. |
author | Metadata | Zaznamená odpovědný zdroj nebo tým. |
language | Metadata | Poskytne normalizovanou jazykovou klasifikaci pro zamýšlené filtrování. |
createdAt | Metadata | Zachová seřaditelné normalizované časové razítko, pokud je RAG služba podporuje. |
_etag | Ani jeden | Jde o interní hodnotu zpracování bez přínosu pro uživatelské vyhledávání. |
Toto rozdělení má podporovat obsahovou otázku například „Co musí zaměstnanec udělat po resetování hesla?“ a je zamýšlené pro filtr například „Dokumenty k identitě v angličtině“. Než se na toto chování spolehnete, otestujte obojí proti nasazené RAG službě.
Frontend zobrazuje obě nastavení jako opakovatelné seznamy názvů polí a před vytvořením datového zdroje odstraňuje položky, jejichž obsah tvoří pouze mezery. Aplikační backend neověřuje, že název existuje v importovaném JSON, a přijaté seznamy beze změny předává do vlastností JsonFeatures a MetadataDefinitions RAG klienta.
Aplikační backend odesílá tyto hodnoty při vytvoření datového zdroje. Samostatně je neukládá do své databáze, nevrací je v aktuálním detailu datového zdroje ani je nepřijímá přes současný update endpoint. Seznamy definujte a otestujte před vytvořením produkčního zdroje.
Aplikace ani backend neurčují přesně, jak samostatná RAG služba indexuje vybrané features, aplikuje metadata filtry, vyhodnocuje vnořené cesty, zpracovává chybějící hodnoty nebo smíšené datové typy ani jak řeší klíč přítomný v obou seznamech. Výše uvedená doporučení považujte za kvalifikovaný výchozí bod. Pilotně importujte reprezentativní záznamy, zkontrolujte extrahované dokumenty a chunky a otestujte alespoň jednu obsahovou otázku a jeden zamýšlený metadata filtr.
Společná pole integračních zdrojů
Každý připojený zdroj vyžaduje Name, volitelný Description, Connection ID a frekvenci synchronizace. Connection ID vybírá uloženou autentizaci; nikdy není polem pro secret.
Frekvence synchronizace
| Frekvence | Použití |
|---|---|
| On Demand | Podepsané politiky, kontrolovaná vydání, čtvrtletní exporty |
| Daily | Provozní dokumentace, aktivní projekty a měněné sdílené složky |
| Weekly | Udržované, ale neurgentní znalosti |
| Monthly | Pomalu měněné archivy a reference |
Manual Upload nemá upstream systém k synchronizaci. Vyšší frekvence není automaticky lepší: spotřebuje kapacitu poskytovatele i zpracování a dříve zpřístupní nezkontrolované změny.
Profily zpracování
Všechny formuláře pro vytvoření zdroje začínají profilem Kvalitní (Quality). Profil nastavuje ukládání vektorů a u podporovaných souborových zdrojů pokročilou extrakci PDF. Nemění přístup ke kolekci, plán synchronizace ani volbu Automaticky zpracovat nalezené soubory.
| Profil | Velikost vektoru | Kvantizace | Pokročilá extrakce PDF |
|---|---|---|---|
| Úsporný (Economy) | 1536 dimenzí | Int8 | U podporovaných zdrojů vypnutá |
| Kvalitní (Quality) | 3072 dimenzí | Žádná | U podporovaných zdrojů zapnutá |
| Vlastní (Custom) | Zvolené hodnoty | Zvolená hodnota | Zvolená hodnota, pokud je podporovaná |
Pokročilou extrakci PDF podporují Manual Upload, Google Drive, OneDrive, SharePoint, Azure Storage Account a Azure File Share. Jira, Confluence a Firecrawl tento přepínač nenabízejí. Profil Quality u těchto tří zdrojů stále nastavuje 3072 dimenzí a žádnou kvantizaci.
Profil Vlastní otevře Pokročilá nastavení pro ruční úpravy. Vypnutí samotné pokročilé extrakce při zachování 3072 dimenzí a žádné kvantizace také vytvoří vlastní konfiguraci. Po přepnutí profilu zkontrolujte konečné hodnoty; volba Economy nebo Quality přepíše nastavení, která daný profil řídí.
Economy použijte, pokud se pro ověřený obsah hodí menší vektory a nižší nároky na úložiště. Quality zvolte, pokud využijete větší vektory a podporovanou extrakci PDF. Žádný profil nezaručuje lepší odpovědi u každého dokumentu. Změnu produkčního nastavení nejprve porovnejte na reprezentativních otázkách.
Další volby zpracování
Podle zdroje část Zpracování (Processing) nabízí také Povolené typy souborů, Ukládat zdrojové soubory, vyloučení cest a JSON Features a JSON Metadata Definitions. V Pokročilých nastaveních jsou dostupné volby vektorů a dělení obsahu. U podporovaných vzdálených zdrojů je ukládání originálů výchozí vypnuté; Manual Upload originály uchovává.
Přiřazení kolekce agentovi určuje, ke kterému obsahu má agent přístup. Profil zpracování nenahrazuje ověření kvality vyhledávání ani neuděluje přístup k jiné kolekci.
Vyloučení cest k souborům
Při vytváření zdroje přidejte do Vyloučení cest k souborům (regex) jeden výraz na řádek. Později je lze upravit v Konfiguraci. Jde o regulární výrazy .NET, které se hledají kdekoli v celé cestě včetně složek. Složky oddělujte /. Rozlišuje se velikost písmen; pro její ignorování přidejte (?i).
| Příklad | Co vyloučí |
|---|---|
(^|/)archive/ | Soubory ve složce pojmenované archive |
(?i)\.tmp$ | Cesty končící na .tmp bez ohledu na velikost písmen |
Prázdný seznam nic nevyloučí. Nejde o zástupné vzory typu *.tmp. Neplatný regulární výraz nelze uložit. Odpovídající soubory se přeskočí před odhadem a zpracováním; důvod ověřte v Souborech.
Změny se použijí v dalších bězích. Po odebrání pravidla může příští discovery znovu najít i nezměněný soubor dříve přeskočený tímto výrazem. Úprava filtru sama o sobě nemaže již indexovaný obsah.
Kontrola před produkcí
Detail zdroje má záložky Přehled (Overview), Konfigurace (Configuration) a Soubory (Files). V Přehledu najdete Aktualizace (Updates) s výsledky běhů a schvalováním; akce View details otevře souhrn aktualizace. Zpracovaná data ukazují metriky indexovaného obsahu a Přeskočená data výsledek discovery. Přeskočené řádky prohlédněte v Souborech a otevřete akcí Show. Konfigurace slouží k úpravě zdroje; Soubory také ke kontrole stavů, dostupných náhledů originálů a extrahovaných částí textu.
Stav Čeká na potvrzení vyžaduje schválení, pokud není zapnuté automatické zpracování. Discovered ani Estimated nedokládají dokončenou indexaci. Pending znamená probíhající zpracování; zkontrolujte konečnou aktualizaci i jednotlivé soubory.
Otestujte známou přítomnou odpověď, známou chybějící odpověď, rozporné verze, nedávno změněnou položku a očekávanou výjimku.
Řešení potíží
| Příznak | První kontrola |
|---|---|
| Čeká na potvrzení | V Přehled → Aktualizace zkontrolujte a schvalte nebo zamítněte vybraný běh |
| Počty discovery nesouhlasí se zpracovanými soubory | Odhady, přeskočení, pozdější rozhodnutí podle kvóty či obsahu a správně vybraná aktualizace |
| Connection ID je prázdné | Kompatibilní Connection existuje a je správně viditelné či sdílené |
| Úspěšný zdroj má nula souborů | Pravopis selektoru/cesty/klíče, oprávnění účtu, typy souborů |
| Chybí Google složka | Folder ID, Shared Drive/subfolder přepínače a přístup účtu |
| Chybí Microsoft složka | Přesná relativní cesta, drive/site/library a přístup účtu |
| Azure zdroj je prázdný | Selektor blobu nebo přesný share name a platnost credentials |
| Jira nebo Confluence je prázdná | Project/Space Key a oprávnění servisního účtu |
| Firecrawl obsahuje balast | Zúžit include regex, přidat výjimky, snížit limit |
| Dokument existuje, ale agent jej nepoužije | Indexed/Readable, chunky, přiřazení kolekce, retrieval settings |
| Plánovaný refresh se zastavil | Stav Connection, expirace tokenu, Přehled → Aktualizace, plán a kvóta |
Pokud chybný obsah představuje významné riziko, odpojte kolekci od produkčních agentů, zachovejte netajné diagnostické podklady, určete zda selhalo oprávnění, selektor, sync, extrakce, indexace či retrieval, opravte na testovacím agentovi a před obnovením znovu spusťte evaluation set.
Související dokumentace
Reference dokumentů v odpovědi
Po úspěšném search může interní chat uchovat strukturované odkazy na vrácené Data dokumenty. Identifikují kolekci, zdroj a dokument, ale neobcházejí oprávnění ani nenahrazují důkaz o zpracování. Viz Dokumenty použité v odpovědi; sem se vraťte, pokud je odkazovaný dokument chybějící, zastaralý, nečitelný nebo se špatně vyhledává.
Pokročilá extrakce obsahu PDF
Advanced content extraction je processing cesta určená výhradně pro PDF, jejichž význam závisí na layoutu stránky, tabulkách nebo obrázcích. Pokud je přepínač zapnutý a nalezený dokument je PDF, Siesta AI jej odešle do Azure Document Intelligence, použije model prebuilt-layout a vyžádá Markdown i data obrázků. Word, Excel, PowerPoint, JSON a textové soubory pokračují přes své standardní readery.
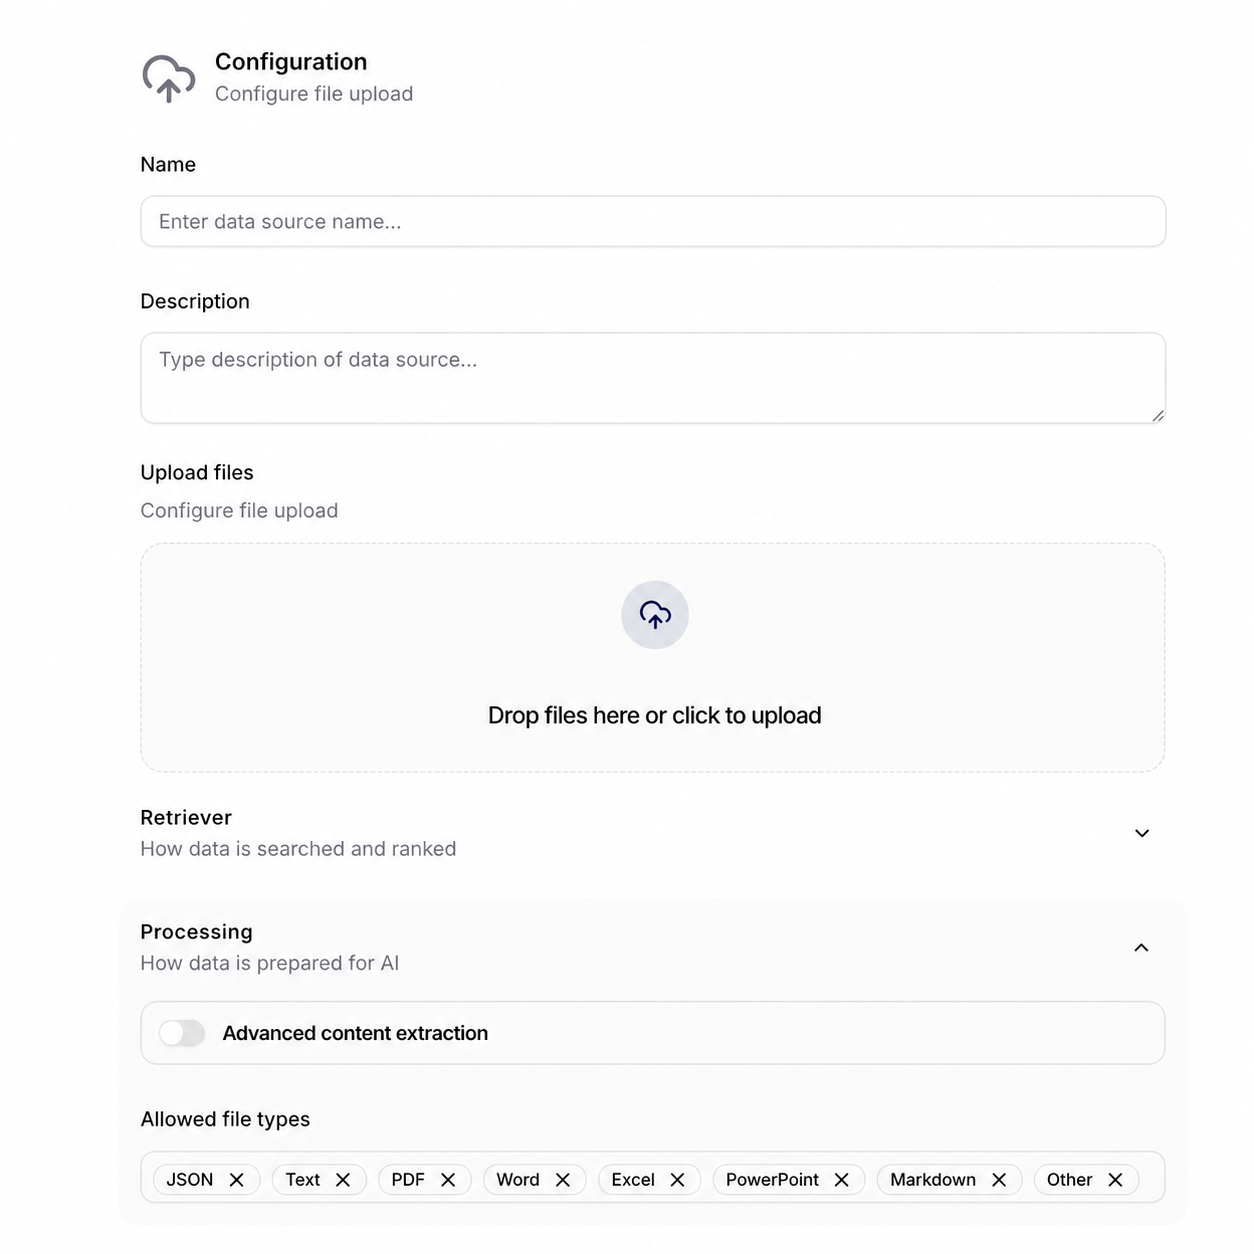
Výsledkem je layout-aware Markdown, samostatné tabulkové prvky s hlavičkou a obrázkové prvky s obrazovými daty, pokud je služba vrátí. Při chunkování se tabulky a obrázky umístí poblíž původní pozice, vytvoří se jejich textový popis a ten se vloží jako searchable chunk s embeddingem. Každý významný vizuální údaj proto ověřte proti zdrojové stránce.
Aktuální PDF cesta je implementována pro Manual Upload, Google Drive, OneDrive, SharePoint, Azure Storage Account a Azure File Share. Neobchází oprávnění poskytovatele, scope zdroje, filtry ani chyby connection.
Azure Document Intelligence se účtuje podle analyzovaných stránek. Počet se zvýší po vrácení analýzy, i když pozdější filtr, nezměněný hash, prázdný obsah nebo jiné ingestion rozhodnutí dokument přeskočí. Opakovaný sync PDF tedy může zvýšit počet stránek bez nové indexované verze. Sledujte Přehled → Zpracovaná data zdroje a limit analyzovaných stránek.
Funkci zapněte pro skenovaná PDF, vícesloupcové dokumenty, složité tabulky a důležité diagramy. U běžných textových PDF ji vypněte, pokud standardní reader vytváří čistý a úplný text.
Před nasazením na velký zdroj otestujte reprezentativní textové, skenované, table-heavy a figure-heavy PDF. Ve Files ověřte stavy Indexed a Readable, zkontrolujte reading order a chunky a položte otázky vyžadující přesné tabulkové i vizuální údaje. Zaznamenejte také nárůst analyzovaných stránek.
| Příznak | První kontrola |
|---|---|
| PDF je přeskočeno s User analyzed pages limit exceeded | Efektivní limit vlastníka a součet napříč všemi jeho datovými zdroji |
| Tabulky nebo obrázky se špatně vyhledávají | Extrahované chunky, vygenerované popisy, reading order a retrieval test |
| Počet stránek vzrostl bez nové indexované verze | Zda analýza proběhla před pozdějším filtrem, kontrolou hashe nebo validací obsahu |
| Zdroj obsahuje jen soubory jiné než PDF | Použijí se standardní readery; Advanced content extraction se na ně nevztahuje |
| Synchronizované PDF nelze analyzovat | Oprávnění, selector/path, stav connection, čitelnost souboru, Přehled → Aktualizace a dostupnost Azure processingu |
Vyšší storage limit neřeší vyčerpaný limit analyzovaných stránek; obě kvóty se vynucují samostatně.
Výchozí profil a kontrola stránek PDF
Profil Kvalitní (Quality) zapíná pokročilou extrakci u všech šesti podporovaných souborových zdrojů. Úsporný (Economy) ji vypíná. Pro běžné textové PDF ji můžete vypnout, pokud standardní čtení dává úplný a čistý výsledek; při zachování vektorů 3072 a žádné kvantizace pak jde o profil Vlastní (Custom).
Během discovery se stránky PDF odhadují místně bez placeného volání Document Intelligence. Po schválení se před placenou analýzou ověří, že se celé PDF vejde do zbývajícího limitu analyzovaných stránek. Spotřebu sledujte v Přehled → Zpracovaná data a v limitech analyzovaných stránek.