Režim Discovery
Discovery vyhledá soubory v datovém zdroji a odhadne nároky na jejich zpracování před samotným zpracováním a indexací. Při ručním schvalování každá aktualizace čeká na rozhodnutí podle seznamu souborů, odhadů a pravidel vyloučení.
Discovery je součástí cyklu aktualizace zdroje. Samotné nalezení souboru nebo odhad jeho obsahu nezpřístupní obsah agentům; k tomu je potřeba úspěšné zpracování a indexace. Snímky na této stránce ukazují anglické rozhraní.
Automatické a ruční zpracování
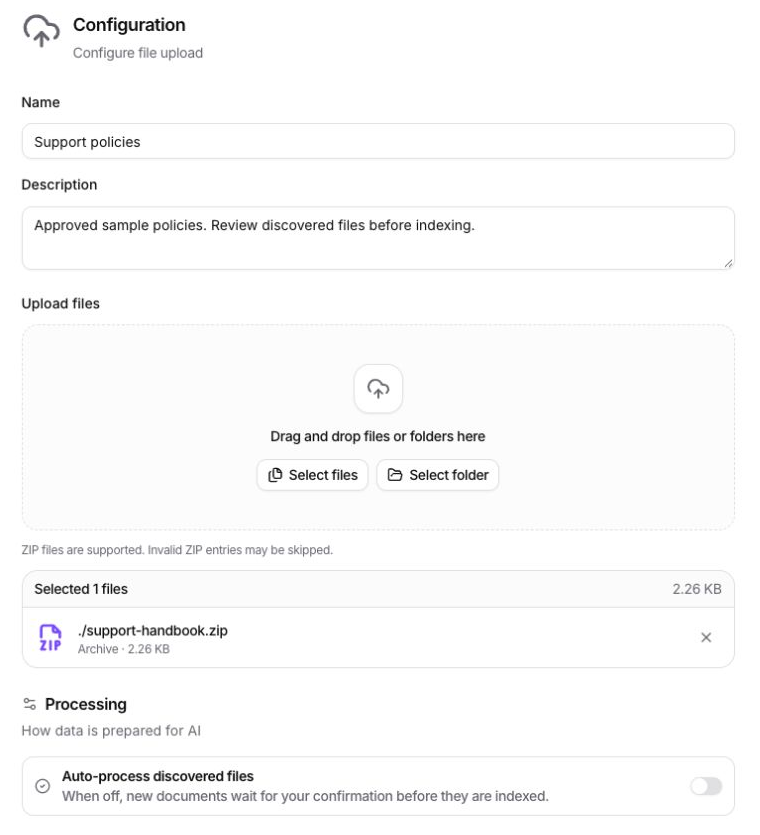
Volba Automaticky zpracovat nalezené soubory (Auto-process discovered files) určuje, zda aktualizace vyžaduje schválení. Je dostupná při vytváření datového zdroje a ve webové aplikaci je ve výchozím stavu vypnutá.
| Nastavení | Chování |
|---|---|
| Vypnuto | Nejprve proběhne discovery a odhad. Před zpracováním aktualizace čeká na ruční schválení. |
| Zapnuto | Discovery a odhad proběhnou také. Způsobilé soubory pokračují ke zpracování automaticky. |
Toto nastavení určuje jen to, zda se soubory zpracují automaticky, nebo až po schválení. Zvolený profil ani četnost aktualizací zdroje se tím nemění.
U zdrojů vytvořených přes API je automatické zpracování ve výchozím stavu zapnuté. Nastavení AutoConfirmed=false znamená, že každou aktualizaci musí před zpracováním schválit uživatel.
Profily zpracování
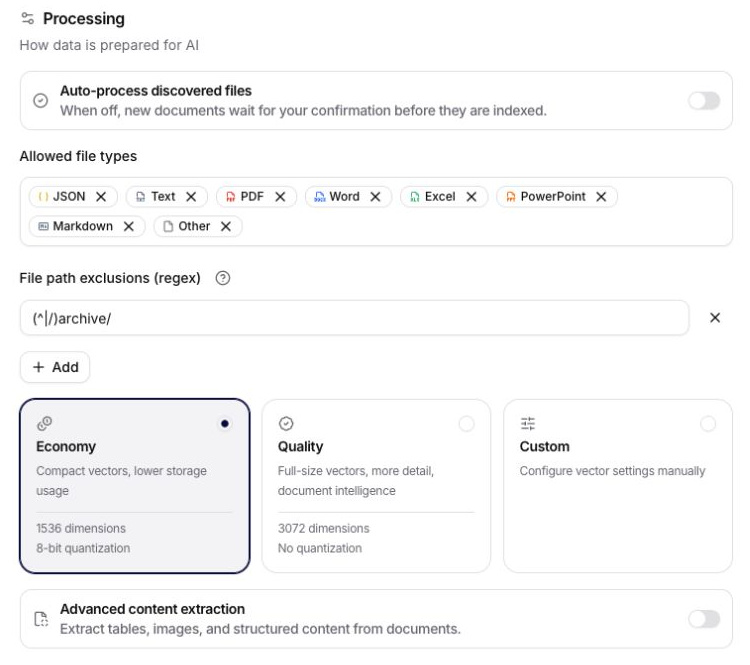
Profil zpracování určuje nastavení ukládání vektorů a u podporovaných souborových zdrojů také pokročilou extrakci PDF. Ve formuláři pro vytvoření zdroje je výchozí profil Kvalitní (Quality).
| Profil | Počet dimenzí vektoru | Kvantizace | Pokročilá extrakce PDF |
|---|---|---|---|
| Úsporný (Economy) | 1536 | Int8 | Vypnuto |
| Kvalitní (Quality) | 3072 | Žádná | Zapnuto |
| Vlastní (Custom) | Nastavená hodnota | Nastavená hodnota | Nastavená hodnota |
Pokročilá extrakce PDF je dostupná pro Ruční nahrání, Google Drive, OneDrive, SharePoint, Azure Storage Account a Azure File Share. Ostatní zdroje tento přepínač nenabízejí. Profil nemění požadavky na schválení ani oprávnění ke kolekci. Podrobnosti popisují Profily zpracování.
Na snímku je vybraný profil Úsporný (Economy) a vypnuté automatické zpracování.
Aktualizace a stavy
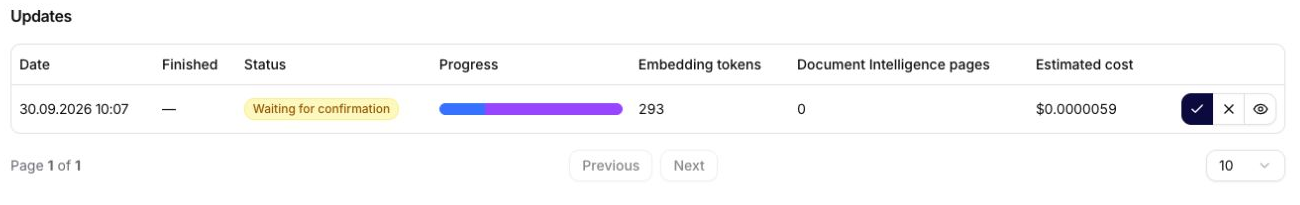
Detail zdroje obsahuje záložky Přehled (Overview), Konfigurace (Configuration) a Soubory (Files). Část Přehled → Aktualizace (Overview → Updates) zobrazuje jednotlivé běhy aktualizací, jejich stav a dostupné akce. Akce View details otevírá souhrn vybrané aktualizace.
| Fáze nebo stav | Význam |
|---|---|
| Discovery a odhad | Zdroj vyhledává způsobilé soubory a odhaduje jejich obsah. Počty i odhady se ještě mohou měnit. |
| Čeká na potvrzení (Waiting for confirmation) | Discovery dospělo do fáze kontroly. Před zpracováním aktualizace vyžaduje schválení. |
| Čekající (Pending) po schválení | Zpracování probíhá na pozadí. Samotné schválení nedokládá dokončenou indexaci. |
| Dokončené zpracování | Aktualizace zaznamenává výsledek běhu. Stavy jednotlivých souborů ukazují, které se indexovaly, přeskočily nebo selhaly. |
| Zamítnutá aktualizace | Čekající běh nepokračuje ke zpracování. Příští discovery může stejné soubory najít znovu. |
Souhrn aktualizace a odhady
Souhrn aktualizace (Update summary) popisuje vybraný běh: počty a velikosti souborů, odhad tokenů pro embedding, odhad analyzovaných stránek, odhad ceny a přeskočená data, pokud jsou tyto údaje dostupné. Rozdělení podle typu souboru nabízí pohled podle Velikosti (Size), Tokenů (Tokens) a Počtu souborů (File count).
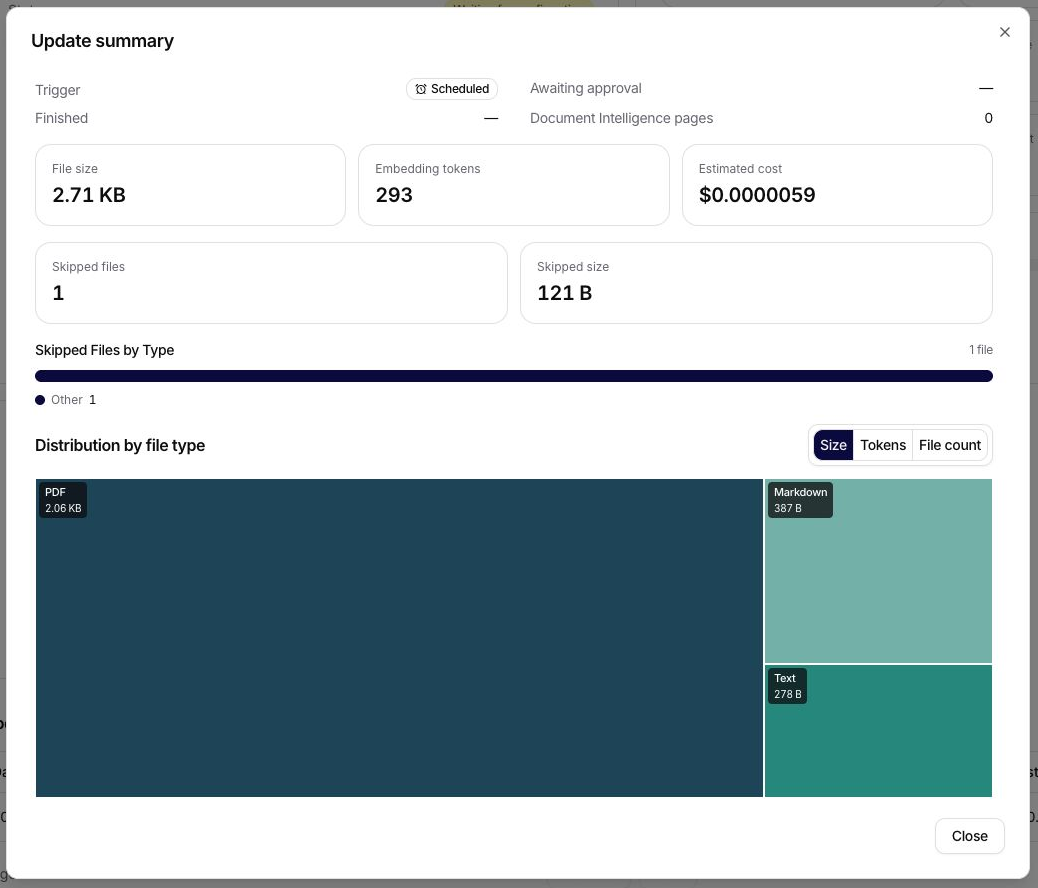
Odhady mohou být neúplné během discovery nebo při nedostupnosti některé hodnoty. Chybějící hodnota neznamená nulovou spotřebu ani nulovou cenu. Discovery může soubory číst nebo stahovat kvůli odhadu jejich obsahu. Odhad počtu stran PDF používá místní kontrolu souboru; placená pokročilá extrakce PDF probíhá při zpracování po ručním či automatickém schválení.
Jednotlivé metriky popisují různé prostředky:
| Metrika | Význam |
|---|---|
| Velikost souboru | Velikost zdrojového obsahu, oddělená od jeho vektorové reprezentace. |
| Odhad tokenů pro embedding a ceny | Předpokládaná spotřeba při zpracování, nikoli konečné vyúčtování. |
| Odhad velikosti indexu | Předpokládané úložiště vektorů, oddělené od uložených originálů. |
| Uložené originály | Zdrojové soubory uchované pro náhled nebo stažení, pokud je tato možnost podporovaná a zapnutá. |
| Analyzované stránky | Stránky analyzované pokročilou extrakcí PDF; jejich limit je nezávislý na úložišti. |
Limity nahrávání a účinné limity úložiště a analyzovaných stránek vlastníka zdroje popisují Limity nahrávání dat.
Schvalování a zamítání
Akce Schválit (Approve) a Zamítnout (Reject) se vztahují k jedné vybrané aktualizaci v části Přehled → Aktualizace. Obě vyžadují oprávnění upravovat kolekci.
Akce Schválit otevře potvrzovací dialog a po potvrzení spustí zpracování na pozadí. Nezaručuje indexaci každého souboru. Filtry, nečitelný obsah nebo nedostatečný limit úložiště či analyzovaných stránek mohou způsobit přeskočení nebo selhání souboru.
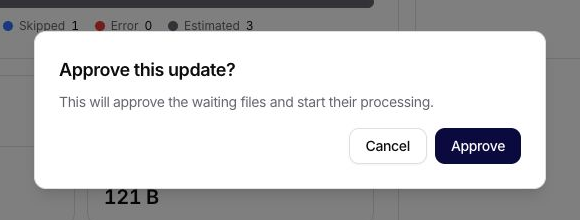
Akce Zamítnout je dostupná pouze během čekání na potvrzení. Zastaví pokračování tohoto běhu; již schválené zpracování zrušit nemůže. Zamítnutí soubory nevylučuje natrvalo: příští discovery je může najít znovu, i když se jejich obsah nezměnil. Soubory smazané uživatelem se znovu nenačítají.
Vyloučení souborů a přeskočená data
File path exclusions (regex) umožňuje vynechat soubory podle jejich názvu nebo složky, aniž byste museli každý soubor vypsat zvlášť. Regex neboli regulární výraz je textový vzor. Pokud mu cesta k souboru odpovídá, soubor se přeskočí ještě před odhadem a zpracováním.
Pravidlo se porovnává s celou cestou ke zdrojovému souboru, včetně složek oddělených lomítkem /. Stačí shoda v kterékoli části cesty. Samotné slovo archive tak zachytí i old-archive/report.pdf nebo notes/archive-plan.md. Pro vynechání konkrétní složky je proto vhodné přesnější pravidlo.
Jak číst příklad (^|/)archive/:
^znamená začátek cesty.|znamená „nebo“ a závorky spojují obě možnosti. Část(^|/)tedy říká „na začátku cesty nebo hned za lomítkem/“.archive/je přesný název složky zakončený lomítkem. Pravidlo zahrne i soubory v jejích podsložkách.
Pravidlu odpovídá archive/legacy-policy.md i team/archive/2025/report.pdf. Naopak old-archive/report.pdf ani archive-plan.md mu neodpovídají.
| Pravidlo | Které soubory přeskočí |
|---|---|
(^|/)archive/ | Soubory ve složce archive, ať je kdekoli v cestě |
\.tmp$ | Soubory s příponou .tmp |
\.(png|jpg|jpeg)$ | Soubory s kteroukoli z těchto tří přípon obrázků |
(^|/)draft\.docx$ | Soubor s přesným názvem draft.docx v libovolné složce |
V příkladech znamená \. obyčejnou tečku a $ konec cesty. Pro příponu tedy použijte \.tmp$; zápis s hvězdičkou *.tmp jako regex nefunguje. Rozlišují se velká a malá písmena: \.tmp$ nezachytí REPORT.TMP. Pokud na velikosti písmen nezáleží, přidejte na začátek (?i), například (?i)\.tmp$.
Každé pravidlo přidejte na samostatný řádek. Soubor se přeskočí, pokud odpovídá alespoň jednomu z nich. Prázdný seznam nic nevylučuje; neplatný výraz nelze uložit.
Vyloučení lze nastavit při vytváření zdroje nebo změnit v Konfiguraci (Configuration). Změny platí pro budoucí běhy; úprava pravidla nemaže již indexovaný obsah. Odstranění pravidla umožní znovu nalézt dříve vyloučený soubor, i když se nezměnil. Další příklady uvádí Vyloučení cest souborů.
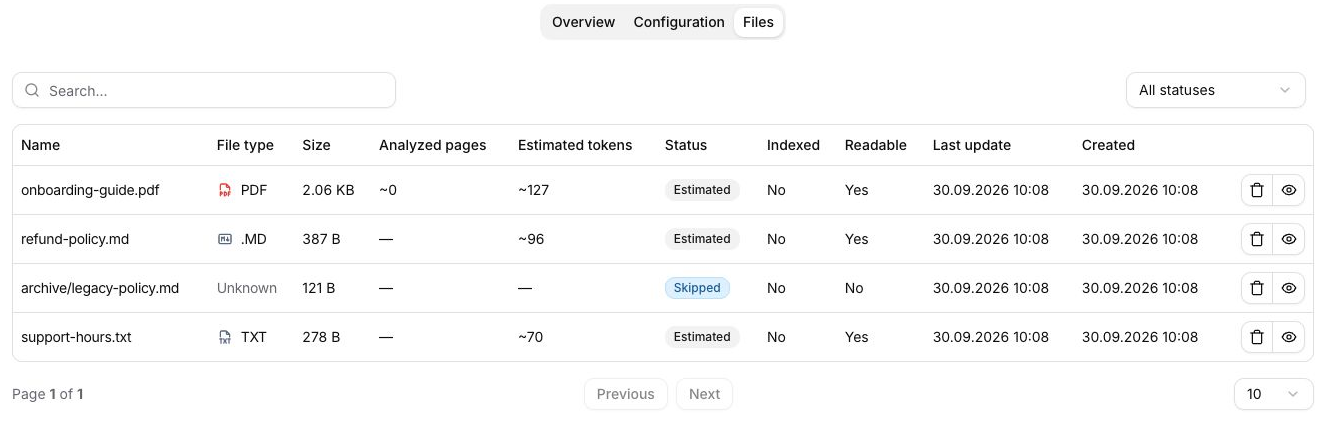
Přeskočená data (Skipped Data) v souhrnu zachycují výsledek discovery. Záložka Soubory (Files) obsahuje jednotlivé řádky a důvody přeskočení. Další soubory mohou být přeskočeny během zpracování, proto se konečné stavy souborů mohou od souhrnu discovery lišit. Přeskočený soubor nemusí znamenat chybu zpracování.
Soubory a indexovaný obsah
Záložka Soubory (Files) zobrazuje nalezené dokumenty, stav jejich zpracování a hodnoty Indexed a Readable. Ty popisují výsledek pro konkrétní dokument; dokončená aktualizace neznamená, že je každý nalezený soubor indexovaný a čitelný.
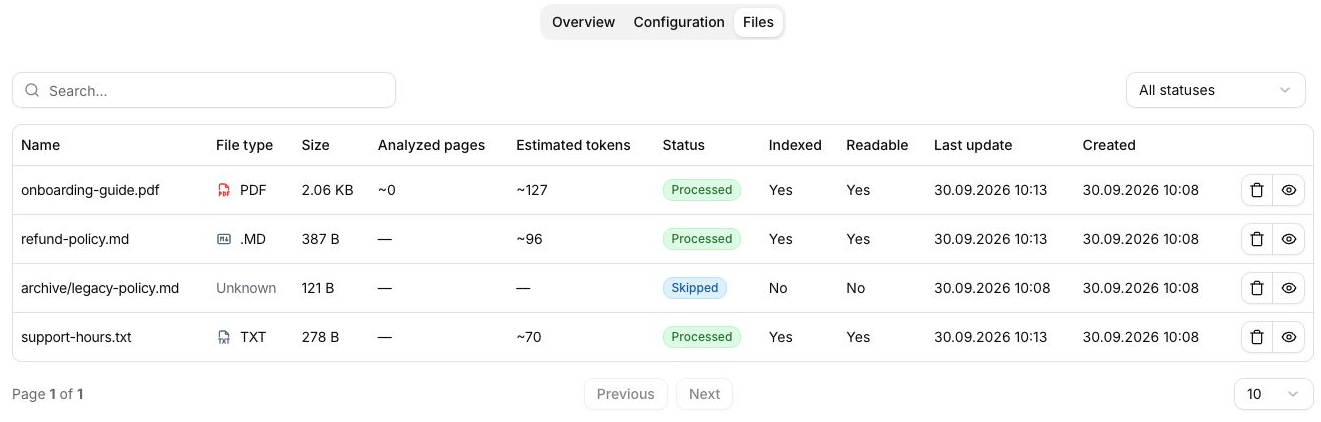
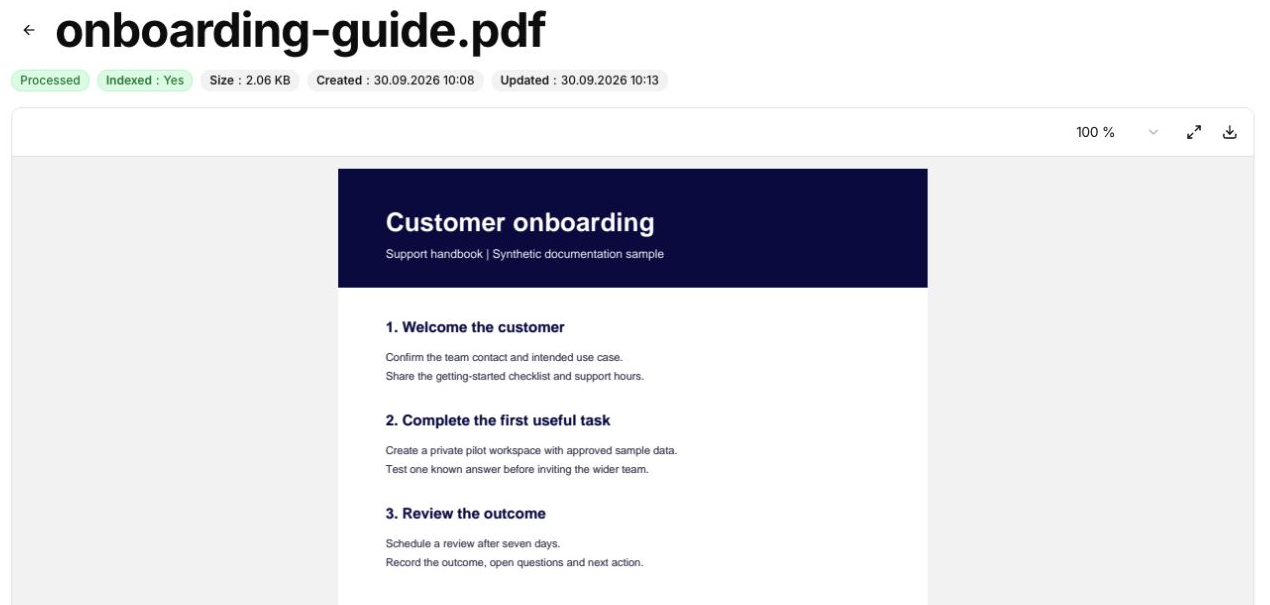
Akce Show otevírá podrobnosti dokumentu včetně extrahovaných částí textu a náhledu originálu, pokud je dostupný. Náhled a stažení originálu vyžadují uložený zdrojový soubor. Extrahovaný obsah a náhled originálu představují různé pohledy na dokument.
Limity a chyby zpracování
Stav Čeká na potvrzení znamená fázi kontroly, nikoli chybu. Selhání discovery a zpracování se zaznamenávají v části Přehled → Aktualizace a u dotčených souborů. Důvody User storage limit exceeded a User analyzed pages limit exceeded odkazují na samostatné limity vlastníka zdroje.
Rozsah zdroje, plán synchronizace, nastavení extrakce a příčiny selhání popisuje Zpracování, synchronizace a řešení potíží. Přidávání obsahu a jeho použití s agentem pokrývá uživatelská příručka Zdroje a soubory.